資料中心 DataFocus OT 產品介紹
DataFocus OT · 企業本體平臺
讓 AI 進入業務,控制權留在你手裡
老闆在催 AI 落地,員工已經在用外面的 AI 工具,IT 和法務卻不敢把企業數據交出去。
DataFocus OT 用業務本體給 AI 三樣東西:一張讀得懂的業務地圖、一條有邊界的通道,以及一套要人批准的動作。這樣,你可以放心地對 AI 說"可以"。
AI 進企業,缺的不是模型
今天的大模型已經很聰明,但放進企業裡,常常缺三樣東西。
缺上下文
模型不認識你的業務。它不知道 CRM、ERP 和合同里的"客戶 A"是不是同一家,不知道"交付"算完工、發貨還是簽收,也不知道哪一版規則正在生效。直接給它數據庫,它只能去猜表名、猜關聯。
缺邊界
讓 AI 直接連數據,它能看什麼、能改什麼都不受控。給每個 AI 單獨配一套權限,既配不過來,也很快對不上。
缺行動能力
只會回答問題的 AI 價值有限。企業要的是發現問題之後能推進處理,而且每一步都在規則之內、有人把關。
業務本體補的正是這三樣。
什麼是業務本體
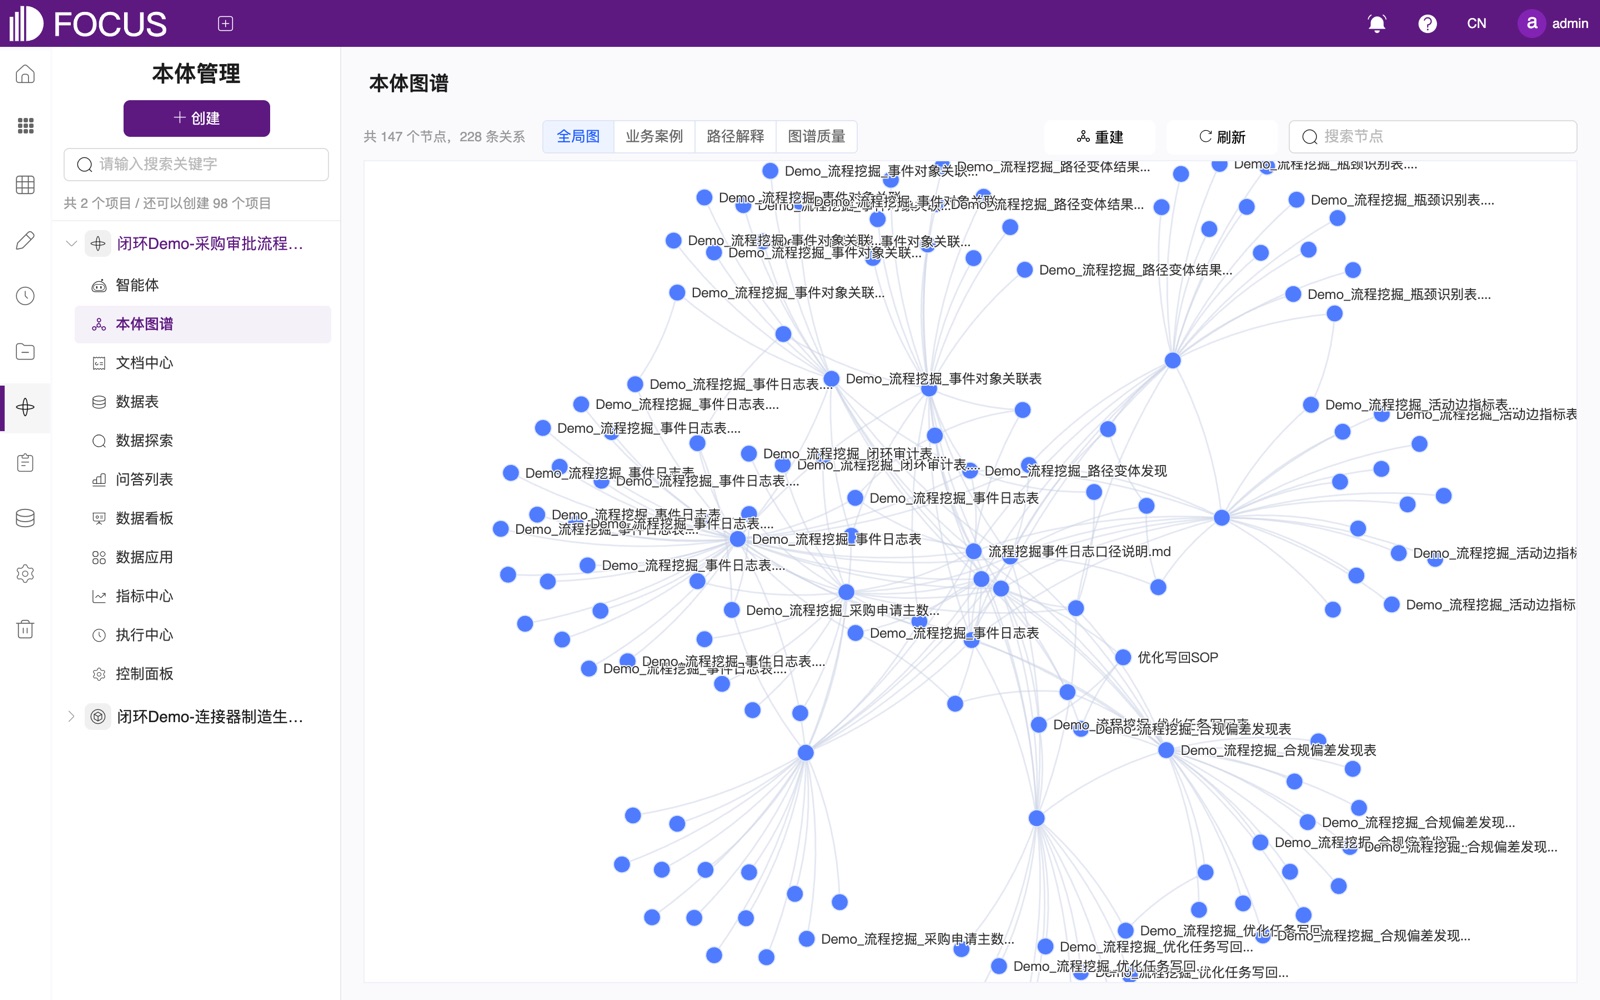
本體是圍繞一個業務主題建立的業務模型。以產品內置的"採購審批"示例本體為例,它由五部分組成。
| 組成 | 在 DataFocus OT 中 | 採購審批本體裡 |
|---|---|---|
| 業務對象與關係 | 把各系統的數據表組織到本體下,寫明表與表如何關聯及其業務含義,並在本體圖譜中呈現 | 採購申請、審批事件日誌、路徑變體、瓶頸、合規偏差、優化任務、審計記錄等 9 張表;例如"審計記錄按案例編號追蹤採購申請" |
| 規則與知識 | 文檔中心存放制度、規則和口徑說明,並關聯到它們約束的數據 | 合規偏差校驗規則、SLA 與瓶頸識別規則、事件日誌口徑說明、任務寫回與審計 SOP |
| 指標 | 指標中心,按計劃推送給相關人員 | — |
| 動作 | 執行腳本(計算、校驗、寫回);控制面板上的業務動作 | "合規偏差檢測"腳本;面板上的重新挖掘、生成整改任務、要求補證、關閉偏差、重開偏差 |
| 權限 | 沿用企業的用戶、角色和資源權限;按本體授權給 AI Agent | 只有被授權的人和 Agent 能看到這個本體 |
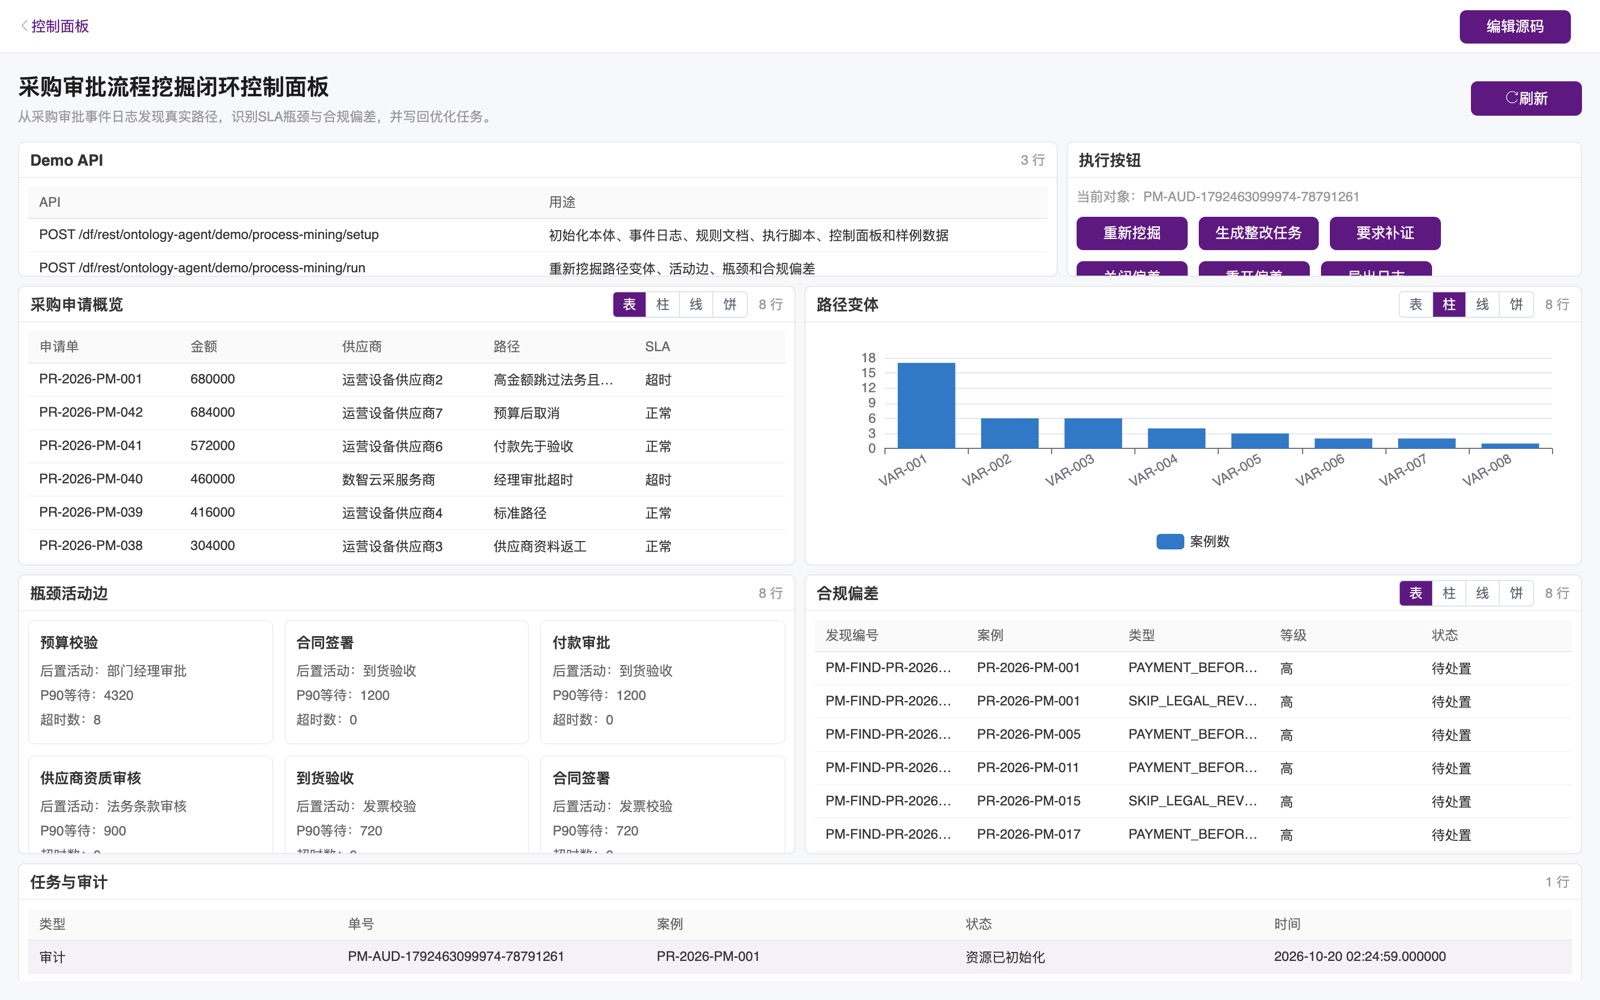
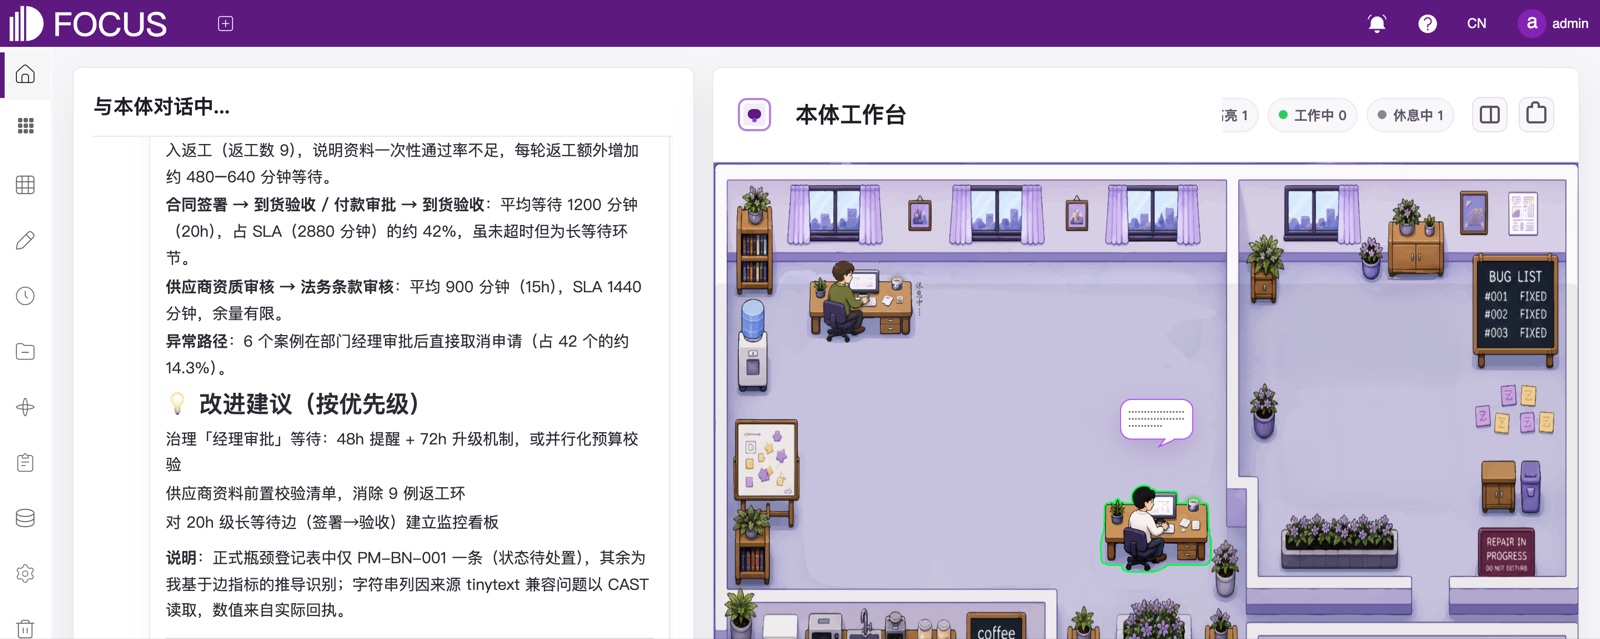
每個本體都配有一個本體智能體:用自然語言向它提問,它會結合本體中的數據和文檔給出有依據的回答,還可以調用本體中的執行項完成分析或寫回。
AI 幫你搭本體。搭本體不必從零手工開始:
- 界面上可以讓 AI 生成執行腳本、生成和修改控制面板的草稿,校驗、預覽之後再保存;
- 外部 Agent 可以根據數據和文檔起草本體,提出需要確認的業務問題,由業務負責人確認後發佈產品方告知 產品方說明已有,本站尚未實測。。
看得見的證據
同一個問題,業務人員和 AI 得到同一組數字(使用產品內置的示例數據)。
業務人員 · 數據搜索輸入"申請部門 金額"
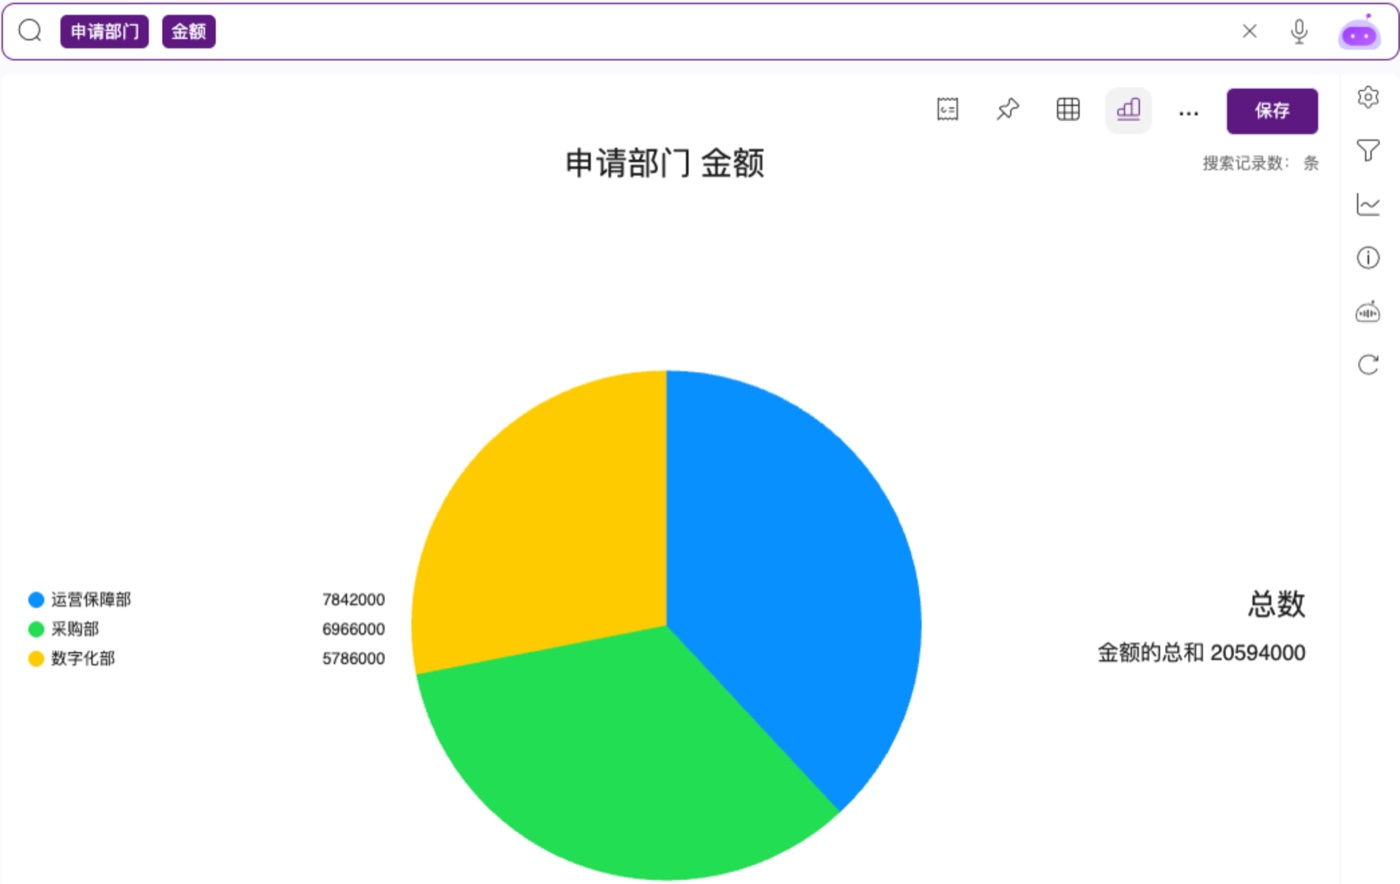
AI Agent · Claude Code 通過 MCP 問同一個問題
金額合計最高的是運營保障部,為 7,842,000 元。
- 運營保障部7,842,000
- 採購部6,966,000
- 數字化部5,786,000
依據:查詢 Demo_流程挖掘_採購申請主數據表,執行 SELECT "申請部門", "幣種", SUM("金額") … GROUP BY "申請部門", "幣種";回執中的數據指紋 evidenceRowsSha256 = 98e5b99a…d159。(回答摘錄)
兩邊的數字逐項相同
本體帶來什麼
一次定義,處處複用
業務口徑在本體裡只定義一次,搜索分析、看板、控制面板、本體智能體和外部 Agent 都用它,得到的是同一組數字。
AI 的回答有依據
AI 沿著本體裡定義好的對象和關係去找數據,不靠猜;每次查詢都返回實際執行的 SQL、所用的數據表和數據指紋。
AI 不越界
權限跟著本體走:Agent 只能拿到授權用戶本人權限內的數據,越權請求不會透露數據是否存在,權限一收回就失效。
從發現問題到解決問題
業務人員在控制面板上選中一條異常,就能生成整改任務、要求補證或關閉偏差;AI 要做改動,只能提交草稿,經人批准後才會生效。
功能之外的價值
敢對 AI 說"可以"
很多企業卡在中間:老闆催 AI 落地,IT 和法務不敢開放數據,員工已經在把數據複製給外面的 AI 工具。DataFocus OT 把"禁止"變成"受控地允許":有權限、能撤銷、改動要批准。AI 用起來了,數據也不再從後門流出去。
掌握 AI 時代的主動權
模型更新得很快。業務知識沉澱在你自己服務器上的本體裡,接入哪個模型、哪個 Agent 由你決定;換了也不用從頭再來,業務知識也不會交給某一家 AI 廠商。
越用越值錢
第一個本體是投入。第二個場景可以複用已有的對象、規則和權限,每多一個 AI 應用,成本就更低。一次性的 AI 試點做完往往就扔了,本體會留下來。
出了錯,能追到責任
每次查詢都有回執,每次變更都有審批記錄,Agent 的全部操作還會記入審計日誌產品方告知 產品方說明已有,本站尚未實測。。用了哪份數據、按哪條規則、誰批准的,都查得到。AI 可以追責,管理層才敢放行。
知識留在公司
老員工腦子裡的規則和處理辦法變成本體。人員流動,知識還在;新同事和新的 AI 應用都從這裡開始。
為什麼是 DataFocus
很多產品都說自己有"本體"。常見的做法大致有四類。
| 做法 | 擅長 | 不足 |
|---|---|---|
| 知識圖譜:從文檔中抽取實體和關係 | 檢索和問答 | 金額、彙總等數字靠模型生成,算不準;沒有業務動作 |
| 指標層或語義層:數據平臺自帶 | 報表數字準確 | 沒有規則文檔和業務動作;綁定在該平臺上 |
| 數據目錄 | 說明數據在哪裡、是什麼 | 只描述數據,不參與業務運行 |
| 重型本體平臺 | 功能完整 | 價格高、實施重,依賴駐場團隊;AI 多綁定自家產品 |
DataFocus OT 的做法
數字算得準。底層是真實的計算引擎(Flash 用 Apache Doris,Heavy 用 Trino 等),回答來自實際執行的 SQL,並帶可核對的回執,不讓大模型去"估"數字。這建立在 DataFocus 搜索式分析產品的基礎之上。
數據、規則、動作在同一個本體裡。數據告訴你發生了什麼,規則告訴你應該怎樣,動作讓你接著處理。
對 AI 開放,但默認受控。用標準 MCP 和 OAuth 接入任何支持 MCP 的 Agent;權限繼承、實時撤銷、變更審批、查詢回執都是內建的,不是外掛的。
輕。私有化部署,Flash 一個引擎就能運行;從一個本體起步,不需要龐大的駐場團隊;AI 還能幫你搭本體。
人和 AI 共用。業務人員手上的搜索分析、看板和推送,用的是同一個本體。投入一次,兩邊受益。
功能一覽
業務人員
- 搜索式分析:輸入列名和關鍵詞即可得到圖表,可查看實際執行的 SQL,支持時序預測和歸因分析。
- 智能問數:用自然語言向 AI 助手"小慧"提問,由它轉換成查詢。
- 本體工作臺:與本體智能體對話,由它結合數據和文檔給出分析。
- 控制面板:查看業務狀態,直接執行業務動作。
- 問答、數據看板,以及定時推送到企業微信、釘釘、飛書。
- 數據填報:設計填報表單,收集和管理數據。
- 21 種界面語言,包括簡體中文、繁體中文、English、日本語、한국어。
AI Agent(通過 MCP 接入)
- 標準 MCP 接口(Streamable HTTP),通過 OAuth 授權;Claude Code 等客戶端可以直接接入。
- 讀取本體、資源和圖譜,在本體範圍內執行只讀查詢,結果附帶 SQL 和數據指紋。
- 提交控制面板等變更草稿,經人工審批後應用。
- 通過 DataFocus 用自然語言完成分析,委託本體智能體執行任務產品方告知 產品方說明已有,本站尚未實測。
AI 自動建模研究產品方告知 產品方說明已有,本站尚未實測。
選定一張業務數據表、設定預測目標和評價指標後,AI 會按以下步驟完成建模研究:
- 先調查數據,再提出基線和候選方案;
- 調用平臺訓練模型並比較效果;
- 用一份事先留出、只用一次的數據,對選定的模型做獨立評分;
- 確認有可靠提升才採用,沒有提升就如實報告;
- 用戶在頁面上下載預測結果和模型訓練包。
整個研究受預算和數據權限約束,可以暫停和恢復;收回數據權限後,研究會隨之停止。
數據與 IT 團隊
- 數據接入:導入數據表、接入外部數據源,建立數據集和公式。
- 數據治理:資產目錄、資產全景、數據服務 API。
- 系統管理:組織架構、角色與資源權限、AD/LDAP 賬號同步,以及外部 Agent 的操作能力和變更審批。
兩個版本
| 對比項 | OT Flash | OT Heavy |
|---|---|---|
| 計算與存儲 | Apache Doris,內存計算與數據倉庫合一 | Hadoop、Hive、Trino、Iceberg |
| 業務本體 | 支持 | 支持 |
| AI Agent 接入(MCP) | 支持 | 支持產品方告知 產品方說明已有,本站尚未實測。 |
| 數據加工 | — | ETL(DataSpring,基於 Flink) |
| AutoML 與 AI 自動建模研究 | — | 支持產品方告知 產品方說明已有,本站尚未實測。 |
| 適合 | 想先在一個業務域快速建起本體,數據可以集中到一個分析引擎的團隊 | 數據量大、已在使用大數據平臺,並需要數據加工和建模的企業 |
第一步:從一個本體開始
- 選一個業務問題:有數據、有制度文檔、有明確負責人,例如訂單交付或採購審批。
- 帶上相關的數據表和規則文檔,建起第一個本體。
- 讓業務人員先用起來,再授權一個 AI Agent 接入。
- 跑通之後,擴展到下一個業務主題。
- 私有化部署:安裝在企業自己的服務器上。大模型服務由管理員在系統中配置;使用外部模型時,請按企業的數據政策確認傳輸範圍。
- 配套資料:中英文用戶手冊(截圖均取自真實產品界面),以及 Agent 與 MCP 接入手冊。
產品方告知 產品方說明已有,本站尚未實測。 產品方說明已有,本站尚未實測。